noda
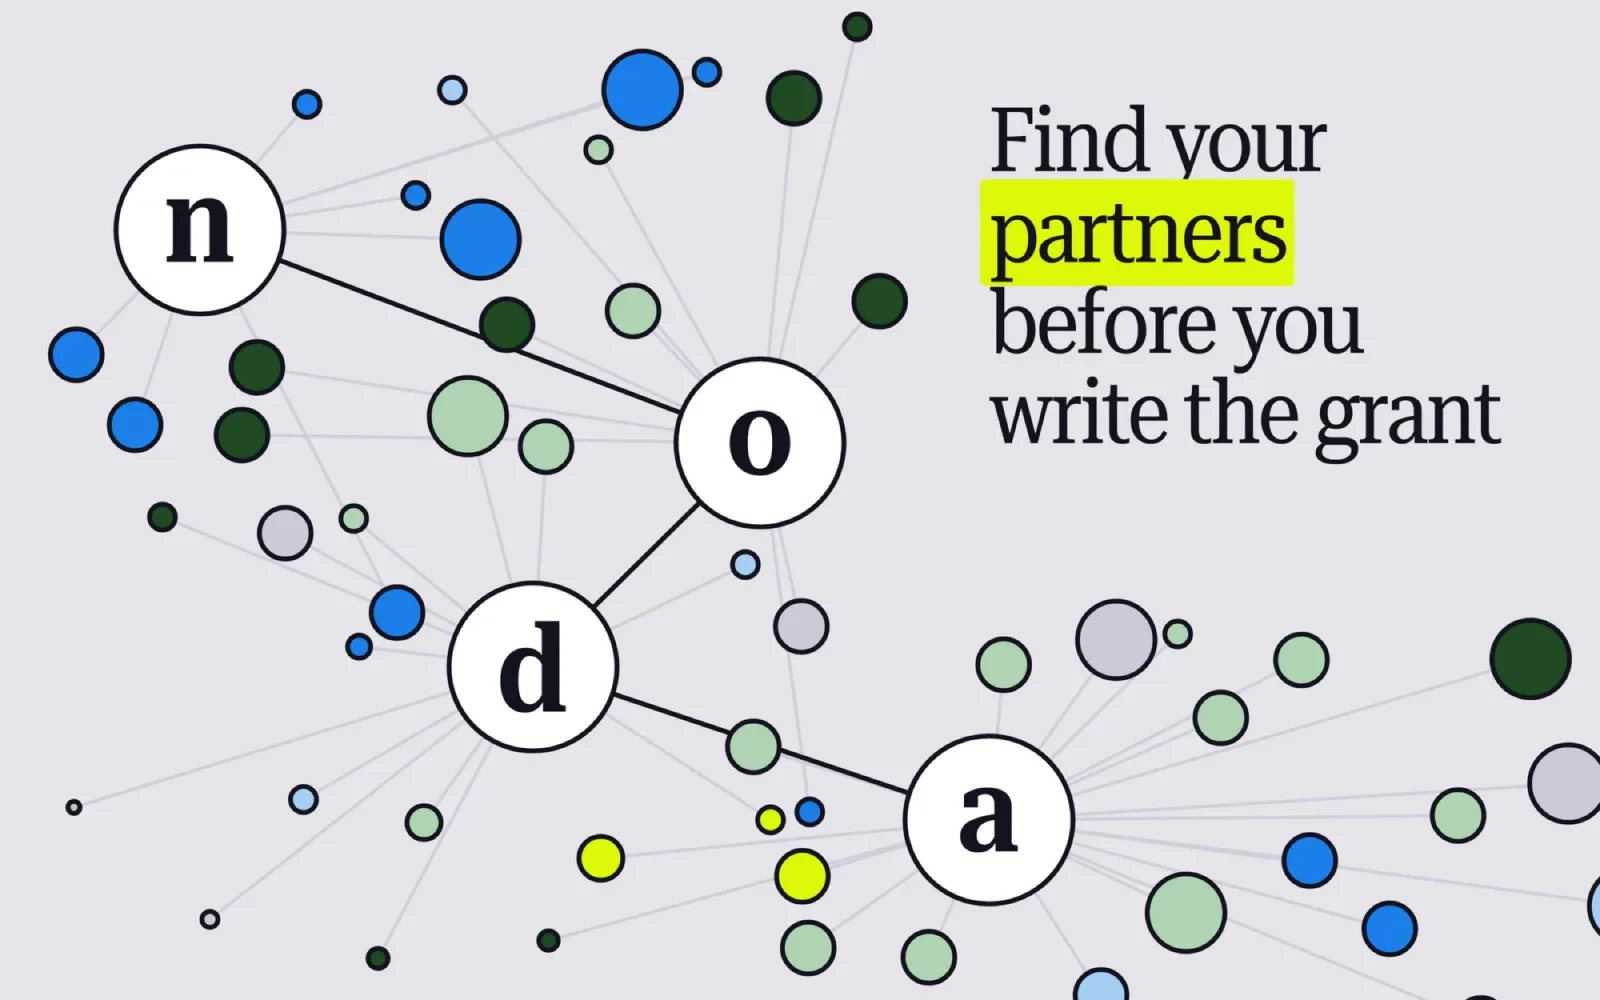
Un outil gratuit en open data pour constituer des consortiums de recherche européens. Il transforme deux jeux de données publics — OpenAlex et CORDIS — en shortlists de partenaires classées, puis accompagne le coordinateur dans la suite du travail : l’appel, les règles d’éligibilité, les lacunes, la comparaison et la prise de contact. Anciennement Open Science Collaboration Network
- Problème
- Trouver des partenaires de consortium Horizon repose sur les réseaux personnels et Google : deux à quatre semaines guidées par la proximité, sans preuve d’adéquation
- Insight
- Un classement brut par publications place Harvard et le MIT en tête de chaque thématique. En pondérant l’historique de projets européens et la position dans le réseau, on fait émerger les institutions qui rejoignent vraiment des consortiums
- Solution
- Une plateforme open data que j’ai construite seule, de bout en bout : un Partner Fit Score de 0 à 100 sur six signaux, une carte du réseau, une analyse des lacunes au regard des règles Horizon, les appels en cours, la comparaison, un pipeline avec brouillons de messages, une recherche sémantique et des synthèses IA
- Résultat
- En ligne sous le nom de noda sur noda.science : 6 thématiques, 8 400+ institutions scorées, 740 000+ liens de collaboration, 0 € par mois. WCAG 2.2 AA avec 0 erreur axe sur 24 écrans
La recherche de partenaires Horizon Europe passe par les réseaux personnels — et cela se voit
Les subventions Horizon Europe (95,5 milliards d’euros sur 2021–2027) exigent presque toujours un consortium multinational d’au moins trois partenaires. Sa composition est un critère d’évaluation et un motif de rejet fréquent. L’outil officiel — Partners Search sur le portail EU Funding — renvoie une liste de noms non classée, sans données de publication, sans contexte de réseau et sans score. Il n’a guère changé en dix ans.
Quatre entretiens semi-directifs avec des chercheurs ayant déposé des projets Horizon ont décrit le même processus : lister les organisations que le porteur connaît déjà par les congrès, chercher les affiliations sur Google Scholar, fouiller CORDIS à la main, demander sur les listes de diffusion. La proximité l’emporte : une organisation hors du réseau du porteur n’avait presque aucune chance d’entrer dans la shortlist, quelle que soit sa pertinence. Et les lacunes du consortium — l’organisme public absent, l’ONG manquante — apparaissaient pendant la rédaction, quand elles coûtent cher à corriger.
Le problème n’est pas le manque de données — OpenAlex et CORDIS sont publics, complets et gratuits. Aucun outil ne les avait assemblés sous une forme adaptée à la façon dont on cherche réellement des partenaires
Shortlist : institutions classées par Partner Fit Score, filtrables par pays, type et score
Quatre points de douleur — et un écran absent du cahier des charges initial
La recherche a combiné quatre méthodes : quatre entretiens de 45 minutes, l’analyse de 12 descriptions de projets Horizon financés sur CORDIS, un audit concurrentiel du portail EU Funding, de ResearchGate et d’ERAPortal, et un spike technique pour vérifier la couverture et la qualité des données d’OpenAlex et de CORDIS.
Point de douleur 1 : la recherche dépend entièrement du réseau. Point de douleur 2 : aucun signal mesurable d’adéquation ; on choisit sur la réputation et la confiance. Point de douleur 3 : les lacunes du consortium sont découvertes tard, pendant la rédaction. Point de douleur 4 : CORDIS est inutilisable sans outil ; les quatre personnes interrogées le connaissaient, aucune ne s’en servait régulièrement.
L’écran des lacunes du consortium est né directement du point de douleur 3. C’est lui qui distingue le plus nettement le produit d’un simple classement d’institutions
Un classement brut par publications place Harvard en tête de chaque thématique — ce qui ne sert à rien
Le Partner Fit Score est une note pondérée de 0 à 100 sur six signaux : pertinence thématique (30 %), activité de publication (20 %), participation à des projets européens (20 %), centralité dans le réseau (15 %), diversité des pays (10 %) et activité récente (5 %). Chaque signal est normalisé par rang centile au sein de la cohorte de la thématique, et non divisé par le maximum. C’était l’erreur de la première version : diviser par le maximum plaçait environ 86 % des institutions sous 30 et n’en laissait qu’une ou deux au-dessus de 70 par thématique.
Chaque score est enregistré avec la contribution de chaque signal, pour qu’un chercheur voie exactement pourquoi une institution est classée là : dans l’aperçu d’une ligne de la shortlist, dans les barres du profil et dans l’anneau du score, qui affiche un signal pendant qu’on pointe sa ligne. Sous le score, le profil présente les preuves : les projets européens de l’institution strictement liés à la thématique, son rôle dans chacun, les partenaires avec qui elle travaille le plus et un historique de réalisations issu de CORDIS.
Profil : anneau du score, décomposition en six signaux, preuves
Réalisations : les résultats des projets auxquels l’institution a participé
L’appariement est volontairement prudent. CORDIS et OpenAlex ne partagent aucun identifiant : les organisations sont donc rapprochées par leur nom au sein d’un même pays. Une correspondance de nom entre 75 et 90 ne compte désormais que si le Research Organization Registry la confirme. Un essai à blanc a montré que cela retire environ 56 % des participations, souvent des universités associées à des hôpitaux du même nom. Les nombres de projets européens sont plutôt sous-estimés, et la page de méthodologie le dit.
De la shortlist au consortium
La première version s’arrêtait à la shortlist. Ensuite, les coordinateurs passent des semaines sur tout le reste : choisir l’appel, vérifier les règles, départager des partenaires presque équivalents, relancer ceux qu’ils ont contactés. Aucun outil gratuit ne couvre cette étape ; le produit s’est donc étendu pour la couvrir, avec des données ouvertes uniquement.
Carte du réseau : clusters, centralité, liens les plus forts
Lacunes du consortium : rôles, règle Horizon, pays comparés aux consortiums financés
Les lacunes sont vérifiées sur des preuves, pas sur un modèle type. Les rôles correspondent aux types d’organisation ROR, et la page précise que c’est indicatif. La vérification d’éligibilité couvre la règle générale des Research & Innovation Actions : trois partenaires dans trois États membres ou pays associés, dont au moins un dans un État membre de l’UE. Vos pays sont comparés aux consortiums réellement financés sur la thématique ; pour Climate adaptation, cela fait 192 projets multinationaux, avec une médiane de sept pays. Les pays Widening sont mis en évidence, car les évaluateurs les accueillent souvent favorablement.
Appels Horizon en cours associés à la thématique, chacun avec un bandeau d’échéance
Comparer 2 à 4 partenaires : les différences d’abord, les lignes identiques repliées
Pipeline : de la shortlist au partenaire, avec la liste de contrôle administrative
Brouillon de message fondé sur des preuves réelles, jamais inventées
Synthèse IA : générée dans le traitement hebdomadaire, jamais au moment d’une requête
Recherche sémantique dans les publications de la thématique

En ligne — six thématiques de recherche, 8 400+ institutions scorées, 740 000+ liens de collaboration
Un outil de développeur devient un produit auquel on fait confiance
Le produit fonctionnait mais ressemblait à un outil de développeur : un tableau de bord bleu nuit, sans porte d’entrée, et un nom trop long pour être dit à voix haute. La refonte lui a donné un nom, noda, de « node » ; une page d’accueil qui explique le produit avant de demander un clic ; et une seule image : les institutions sont des perles, les collaborations les fils qui les relient. Le logo, le graphe et l’illustration de la page d’accueil en découlent tous.
J’ai testé cinq palettes sur les mêmes écrans réels plutôt que sur des nuanciers. La palette retenue a une page gris lavande, un texte couleur encre, un accent cobalt et un surligneur citron vert utilisé une fois par page. Les couleurs vives comme le citron vert et le lilas n’atteignent pas un contraste de 3:1 en nœuds de graphe sur fond clair : chaque nœud a donc un contour couleur encre. Cela n’est apparu que dans le vrai graphe.
Puis un audit graphique, parce que le produit passait tous les contrôles automatiques et avait pourtant l’air inachevé. Les boutons d’une même rangée n’avaient pas la même hauteur, les icônes étaient décalées d’un ou deux pixels par rapport à leur libellé, deux tiers du texte faisaient 11 à 13 px et les étiquettes de la carte du réseau étaient illisibles. Le plancher typographique est passé à 13 px pour les légendes et 15 px pour le texte d’interface. Les contrôles d’une rangée partagent désormais une seule hauteur. L’alignement des icônes a été mesuré par rapport à la hauteur des capitales du libellé plutôt qu’à l’œil : la correction change de signe entre le texte courant et les boutons. La carte affiche les 280 liens les plus forts et n’étiquette que les 18 institutions les plus centrales ; les étiquettes disparaissent plutôt que de rapetisser.
Puis le mouvement, et les détails qui n’apparaissent qu’à l’usage. Le hero de la page d’accueil est une boucle construite dans Cavalry : les quatre pôles sont des perles marquées n·o·d·a, reliées en consortium, tandis que des perles partenaires glissent de leur fil, s’éloignent puis sont rattrapées. Elle tourne en vidéo transparente, HEVC avec canal alpha pour Safari et tous les navigateurs iOS, VP9 pour les autres, avec un bouton pause ; elle s’arrête hors écran et quand l’utilisateur réduit les animations. Les mots courts ne restent plus en fin de ligne : un script lie 256 textes d’interface, et une petite passe fait de même pour les noms issus des données, comme « de la Recherche ». Et plus rien ne bouge tout seul. Changer d’onglet décalait la page de 7 px à cause de la barre de défilement, deux onglets sortaient de la colonne commune, et le hero bougeait à l’arrivée de la police web. Chaque problème a été mesuré, corrigé, puis mesuré à nouveau.
Le hero de la page d’accueil, conçu dans Cavalry : n·o·d·a tiennent pendant que les partenaires vont et viennent
La page 404 reprend la même idée plutôt qu’une illustration toute faite. Les liens inconnus affichaient la page d’accueil avec un statut 404 ; ils ont désormais leur propre page, où 4·0·4 pendent comme un pendule de Newton fait des perles du produit. Toutes les quelques secondes, le 4 extérieur frappe le 0, le fil du 0 casse, il tombe et roule, puis un fil descend le remonter. La scène est dessinée en direct sur un canvas plutôt que jouée en vidéo : elle remplit n’importe quel écran, et l’on peut attraper une perle et la lancer. Rien ne passe jamais sur le texte, et avec les animations réduites c’est une image fixe, le 0 posé au sol.
La page 404 : un pendule de perles 4·0·4, et le 0 perd sans cesse son fil
La page d’accueil sur téléphone
La carte sur téléphone : les étiquettes apparaissent au zoom
Le fichier Figma est un seul design system à deux modes, Wireframe et Hi-Fi, sur des tokens partagés. Après l’audit, j’ai mesuré chaque écran en ligne avec Playwright et reconstruit ce qui avait dérivé, jusqu’à la carte du réseau, qui dans Figma est le vrai graphe : positions, tailles et couleurs reprises du site en ligne. Cette synchronisation a révélé trois vrais bugs que les tests avaient laissés passer. Les pays Widening n’étaient jamais mis en évidence, car une règle CSS déclarée plus loin écrasait la mise en évidence. La visite guidée dessinait un contour de focus autour de toute la boîte de dialogue. Et les téléphones affichaient des étiquettes de 7 px : Cytoscape arrondit le zoom à la puissance de deux supérieure avant de décider si une étiquette est trop petite.
D’abord le traitement par lots : tout calcul coûteux se fait dans l’ETL, l’API ne fait que lire et coûte 0 €
La décision d’architecture la plus importante est invisible pour les utilisateurs : tous les calculs — métriques de graphe, appariement des organisations, scores, embeddings, synthèses IA — se font dans un traitement hebdomadaire. L’API de production est une fine couche de lecture sur des tables Postgres précalculées, sans appel à un LLM au moment d’une requête. Le tout tourne dans un seul conteneur Docker sur un hôte Coolify/Hetzner existant, avec l’ETL hebdomadaire planifié dans le processus : le coût marginal est de 0 €.
Le problème technique le plus difficile a été l’appariement des organisations entre CORDIS et OpenAlex : aucun identifiant commun, seulement des noms et des pays. Le pipeline regroupe d’abord par pays, ce qui réduit l’espace de recherche d’environ 95 %, puis applique une correspondance rapidfuzz token-set, et n’interroge le registre ROR que pour la zone d’incertitude entre 75 et 90. Interroger ROR pour chaque organisation, la conception d’origine, faisait échouer l’ETL ; commencer par la correspondance floue a divisé les appels à ROR par environ cent. Quand ROR est indisponible, une thématique garde les données de la semaine précédente au lieu de compter les erreurs comme des rejets.
Les synthèses dépendent d’offres gratuites de LLM, qui retirent des modèles sans prévenir. Un de ces retraits a figé les synthèses pendant des semaines sans que personne le voie ; le traitement choisit désormais un modèle que le fournisseur propose encore, se rabat sur Google Gemini et échoue bruyamment. Le durcissement est venu en dernier : polices auto-hébergées pour qu’aucune adresse IP de visiteur n’atteigne Google, une Content-Security-Policy sans styles en ligne, des limites de débit fondées sur une adresse qu’un en-tête falsifié ne peut pas choisir, et Dependabot sur chaque dépendance.
La conception qui expirait, la normalisation qui faussait les scores, et les chiffres que j’ai réduits
La conception d’origine de l’appariement interrogeait l’API ROR pour chaque organisation. Ce n’était pas seulement lent : l’ETL expirait. La refonte enchaîne trois couches dans un ordre délibéré — regroupement par pays, correspondance floue, ROR seulement pour la zone d’incertitude — et c’est cet ordre qui permet au pipeline d’aller au bout.
La première version du score divisait chaque signal par le maximum de la cohorte, et c’était faux d’une manière qui n’apparaissait qu’à grande échelle : environ 86 % des institutions tombaient sous 30, si bien que la shortlist ne distinguait plus les institutions entre lesquelles un chercheur choisit vraiment. Le rang centile au sein de la thématique l’a remplacée. Un modèle de score n’est pas terminé quand la formule paraît sensée, seulement quand la distribution de ses résultats sert la décision.
La plupart des corrections des derniers tours ont fait dire moins au produit. Les correspondances de noms non confirmées ne comptent plus : les nombres de projets européens baissent d’environ moitié. Un projet ne compte comme lié à la thématique qu’avec un mot-clé dans son titre ou deux dans son résumé, depuis qu’un mot égaré a fait entrer un projet de réalité virtuelle pour le cinéma dans Climate adaptation. « Data as of » ne compte que les mises à jour complètes des données, pas une synthèse régénérée. Chaque changement a rendu un chiffre plus petit et plus facile à défendre.
En ligne, mesuré, honnête sur ses limites
En octobre 2026 : six thématiques de recherche en ligne, 8 400+ institutions scorées, 740 000+ liens de collaboration. axe signale 0 erreur WCAG 2.2 AA sur 24 écrans, sur ordinateur et sur téléphone, sans défilement horizontal de 320 à 2 560 px. Coût d’infrastructure marginal : 0 €. Durée : de novembre 2025 au MVP de mai 2026, puis le parcours de constitution du consortium, la refonte sous le nom de noda et l’audit graphique en octobre 2026, le tout seule.
Ce que je ferais autrement : valider plus tôt la précision de l’appariement. J’ai construit tout le pipeline avant de mesurer sa précision ; un spike de deux jours sur 200 organisations CORDIS aurait révélé le problème des semaines plus tôt. Et regarder le produit en designer plus tôt, pas une fois les tests au vert : les bugs qui ont le plus compté cette année étaient ceux que seule une personne regardant l’écran pouvait voir.
La difficulté n’a jamais été l’interface. C’était de pouvoir défendre, ligne par ligne, chaque chiffre affiché à l’écran
Sources
- Blondel, Guillaume, Lambiotte & Lefebvre (2008). Fast unfolding of communities in large networks (Louvain). J. Stat. Mech. P10008.
- Freeman (1977). A set of measures of centrality based on betweenness. Sociometry 40(1):35–41.
- Priem, Piwowar & Orr (2022). OpenAlex: a fully open index of scholarly works, authors, venues, institutions and concepts.
- ROR — Research Organization Registry.
- Reimers & Gurevych (2019). Sentence-BERT: sentence embeddings using Siamese BERT-networks.
